古籍智能研究平台
收录 10,559 部古籍,按儒、医、史、子、易、艺、诗、道、集九藏分类。全文检索负责「找得到」,语义检索负责「找得准」——不必先知道书名,也不必先读完整部书。
只想直接翻原文?本站另提供一份可被搜索引擎与 AI 直接读取的静态全文镜像:古籍全文 · 九藏总目 —— 786 部核心典籍逐部全文,含四书五经注疏、正史、本草纲目、资治通鉴、全唐诗等。
直接打开平台 → 无需账号,无需安装
一、它替你解决什么
做古籍研究最耗时间的从来不是读,是找。
记得「某书上说过这么一句」,但记不全、也不知道是哪部哪卷。凭印象翻目录,一天翻不完一藏。
比如某个术语、某个方剂、某个人名,要横向看它在道藏、医藏、子藏里分别怎么被用——这靠单部书的目录做不到。
找书不难,难的是找完之后能顺畅地读下去:篇目在哪一层、上下卷怎么接、读到的这段在整部书里处于什么位置。
这三件事对应三种能力:逐字检索、跨书横向检索、篇目导航与连续阅读。这个平台把它们放在同一套语料上。
二、九藏分类体系怎么用
不是平铺的一万多个书名,而是带层级与路径的结构化语料。
语料按儒、医、史、子、易、艺、诗、道、集九藏组织,每藏下可逐级下钻到子类目。这个划分方式的价值在于:你可以把检索范围收窄到某一藏,而不是在全部一万多部里捞针。
史藏 · 2,043 部
- 全套语料里最大的一宗
- 正史、编年、纪事本末与政书
- 史学与史料研究的主要落点
集 · 道 · 子 · 医 诸藏
- 集藏 1,948 部:别集、总集
- 道藏 1,721 部:道教典籍
- 子藏 1,463 部:诸子与杂著
- 医藏 911 部:中医经典与方书
儒 · 诗 · 艺 · 易 诸藏
- 儒藏 908 部:经部与儒学文献
- 诗藏 776 部:诗集与诗话
- 艺藏 446 部:书画、琴谱与器物
- 易藏 343 部:易学文献
其中医藏与本站的古籍讲堂(91 部经典逐页精读讲义)是打通的同一批书——想快速了解某一部的脉络可以先看讲义,要核原文再回平台检索。
三、一次真实检索的全过程
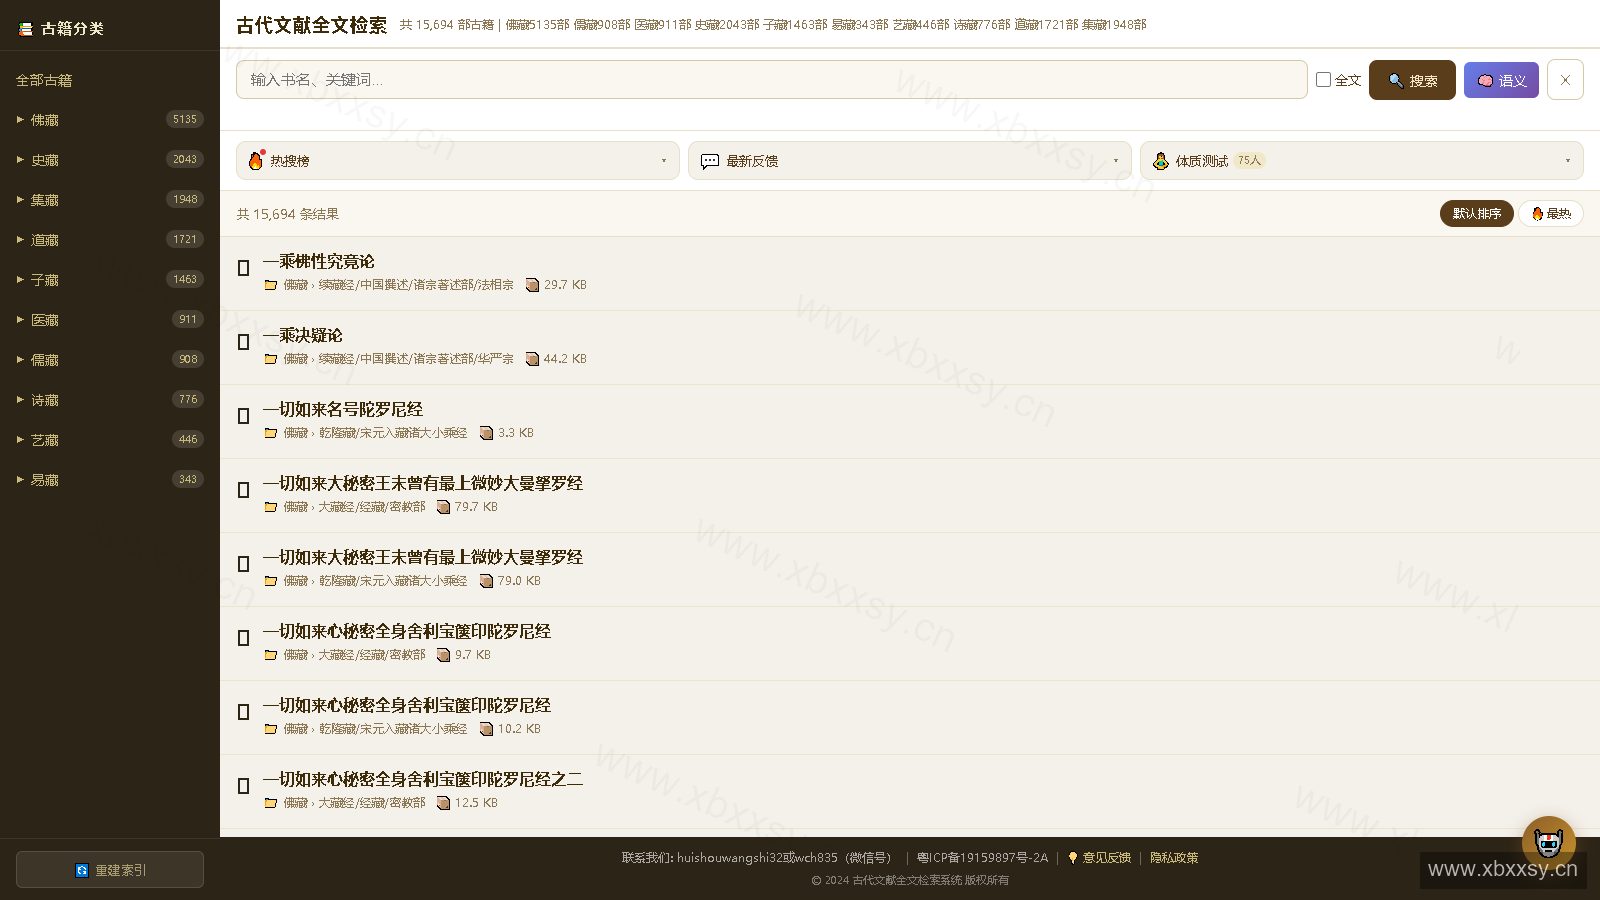
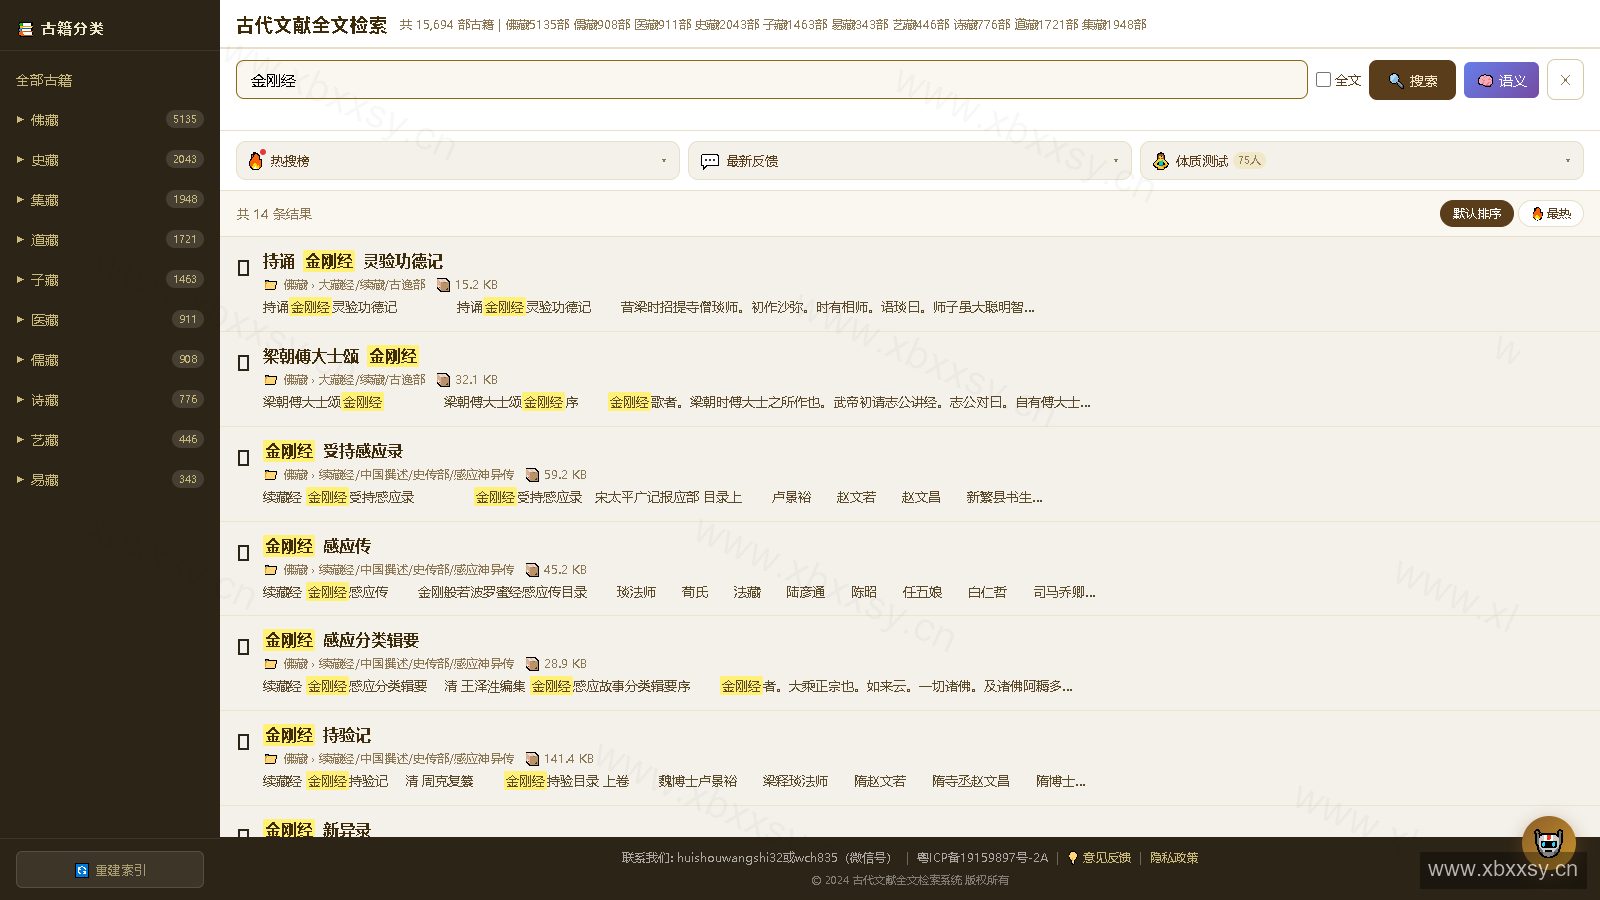
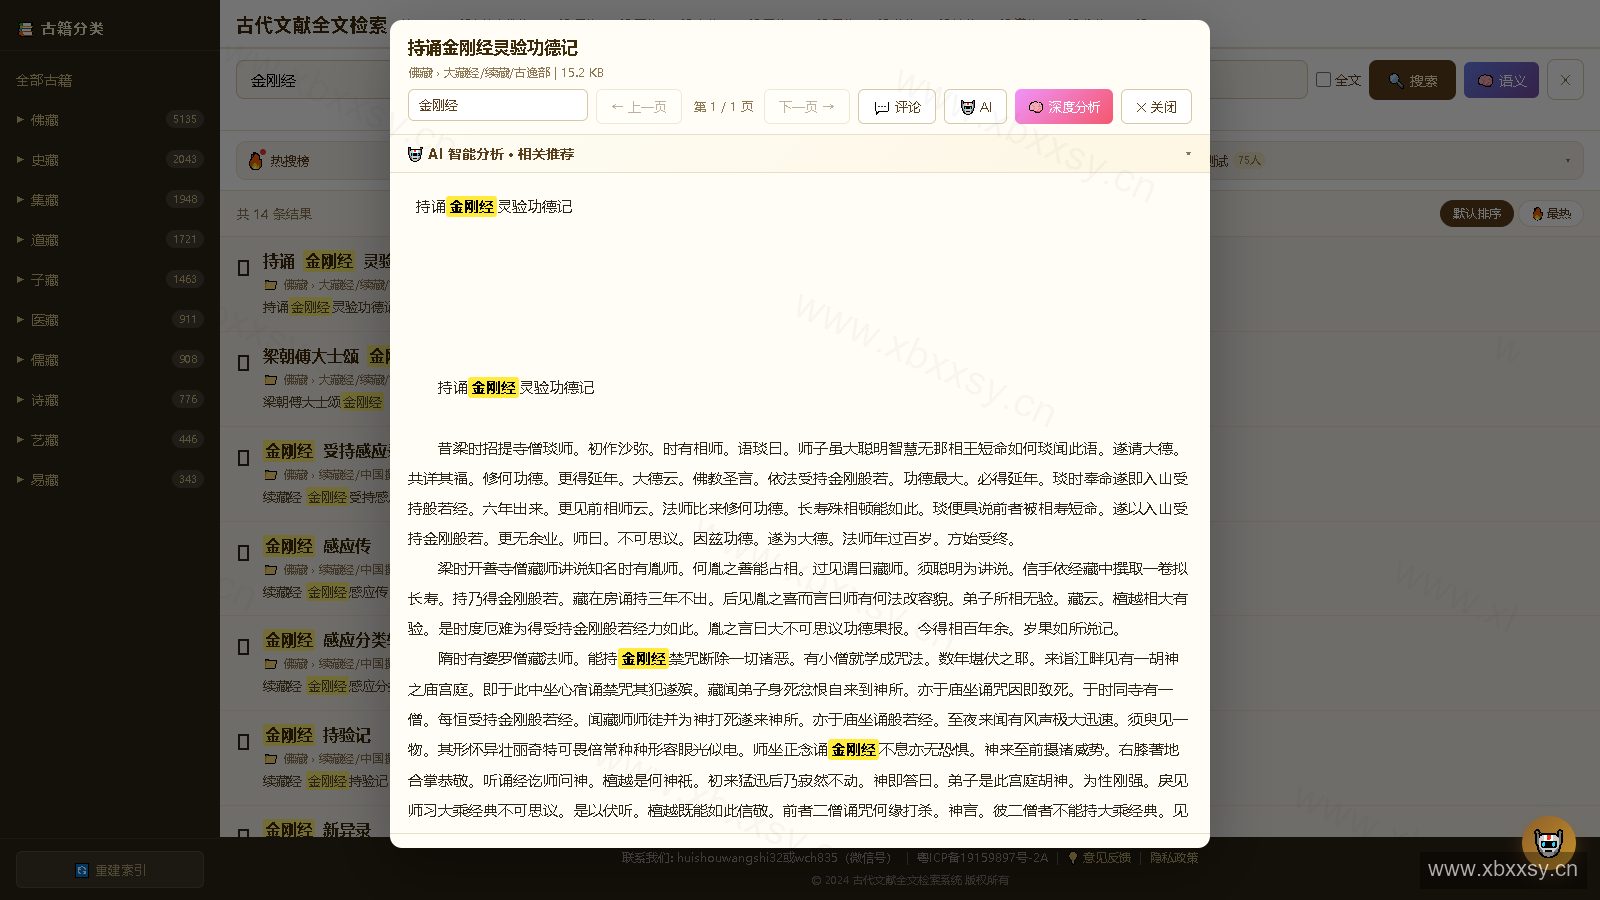
从输入关键词到读到原文,中间只有两步。
- 在首页输入你记得的字句——不需要书名,不需要完整句子。首页同时给出九藏分类入口,如果你已经知道要找哪一藏,直接从分类进更快。
- 看检索结果——每条结果给出命中的书名、篇目归属路径与上下文片段,命中词高亮。归属路径是关键:它告诉你这句话在整部书里的位置,而不是给一个孤立片段。
- 点进原文阅读——直接跳到原文那一句所在的位置,保留分类导航与上下页连续翻阅,读到一半不用退回目录。
四、全文检索和语义检索,什么时候用哪个
两条通道解决的不是同一个问题,用反了会觉得「搜不到」。
全文检索 — 找得到
- 按字面精确匹配
- 你已经记得确切的词或半句话
- 结果可高亮定位,不漏不错
- 不知道出处时首选
语义检索 — 找得准
- 按意思匹配,不依赖原词
- 只记得大意、或想找同义表述
- 召回更宽,需要人工甄别
- 全文检索没结果时换它
实践顺序:先用全文检索,找不到再换语义检索。反过来用会遇到「结果一堆但都对不上」的情况——语义检索召回宽是特性不是缺陷,代价就是要你自己判断。
五、检索词怎么写才容易命中
大部分人第一次用会觉得「搜不到」,问题通常出在检索词上,不在语料上。
全文检索是字面匹配,整句里记错一个字就整条落空。宁可输入四个字的确定片段,也不要赌一整句。
命中几百条说明词太宽,再加一个字;命中 0 条说明词太窄或记错了,换一个同义片段重来。用命中量反推检索词,比一开始就猜哪一藏更快。
同一个词在古书里常有好几种写法,字面检索只认你输的那一种。差一个字没结果时,先用语义检索补一轮,确认是不是写法问题。
想看的不是某一处,而是一个概念在九藏里的分布——这类横向问题用语义检索更省事,字面检索得换着写法搜很多轮。
六、和识典古籍、中华经典古籍库有什么不同
三个平台都在做古籍数字化,但解决的问题不一样。以下是定位对比。
| 对比项 | 本平台 | 识典古籍 | 中华经典古籍库 |
|---|---|---|---|
| 谁在做 | 个人独立开发 | 北京大学与字节跳动 | 中华书局 |
| 使用门槛 | 免注册,打开即用 | 免费开放 | 商业数据库,机构购买或订购 |
| 语料组织 | 九藏体系,史藏 2,043 部为大宗 | 四部丛刊、四库全书等四部体系为主 | 全部为点校整理本 |
| 检索方式 | 全文 + 语义双通道 | 全文检索与智能检索 | 全文检索 |
| 整理加工程度 | 原文本体,保留检索与阅读路径 | 带 OCR、自动标点、实体识别等整理工具链 | 保留专名线、注释、校勘记等全部整理成果 |
| 更适合 | 查出处、跨藏横向检索、史道医藏 | 大众阅读与古籍整理协作 | 需要点校底本的学术引用 |
一句话说清取舍:需要点校底本做严格学术引用,去用中华经典古籍库;要免费读、要参与整理,识典古籍的规模与工具链更完整;手上只有半句话要找出处,或者要在史藏、道藏、医藏里横向查一个概念,这套平台的九藏体系与双检索通道更顺手。
这套平台的语料与检索由我独立维护,规模上比不过前两家的国家队体量,取的是分类体系和检索方式上的针对性。
七、免注册直接开用
没有账号、没有安装、没有试用期。
平台公开运行,直接打开网页就能检索和阅读全文。同一套系统也支持私有化内网部署与二次开发,具体见技术作品页与私有化部署方案。
 扫码添加微信
八、常见问题
古籍智能研究平台是什么?
一个收录 10,559 部古籍的在线全文检索与阅读平台,按儒、医、史、子、易、艺、诗、道、集九藏分类,提供全文检索与语义检索两条通道,并支持篇目导航与原文分页阅读。免注册,打开网页即可使用。
收费吗?需要注册吗?
不收费,也不需要注册或登录。直接打开网页就能检索与阅读全文。
全文检索和语义检索有什么区别?
全文检索按字面匹配,适合已知确切词句时查出处,命中精确、可高亮定位;语义检索按意思匹配,适合只记得大意、或想找同义表述时用,召回更宽但需要人工甄别。建议先用全文检索,找不到再换语义检索。
九藏分类里哪一藏收录最多?
史藏最多,收录 2,043 部;其后依次是集藏 1,948 部、道藏 1,721 部、子藏 1,463 部。九藏为儒、医、史、子、易、艺、诗、道、集,每藏下可逐级下钻到子类目。
和识典古籍、中华经典古籍库有什么区别?
三者定位不同。识典古籍由北京大学与字节跳动联合推出、免费开放,语料以四部丛刊、四库全书等四部体系为主,并带 OCR、自动标点等整理工具;中华经典古籍库由中华书局推出,全部为点校整理本,是面向机构的商业数据库,适合需要点校底本做学术引用;本平台以九藏体系统摄语料、史藏 2,043 部为大宗,走全文加语义双检索,免注册公开可用。
能用来查一句话出自哪部书吗?
可以,这是最主要的使用场景。输入记得的半句原文,检索结果会给出命中的书名、篇目归属路径与上下文,点开直接跳到原文那一句,命中处高亮显示。
数据可以导出或者批量获取吗?
平台面向上机检索与阅读使用。批量数据导出、语料对接或私有化部署需求,可以在作品集页面留下联系方式单独沟通。
这套平台是谁做的?
由山里人独立开发与维护。